Synthesia crea un avatar digitale interattivo per un giornalista: come funziona
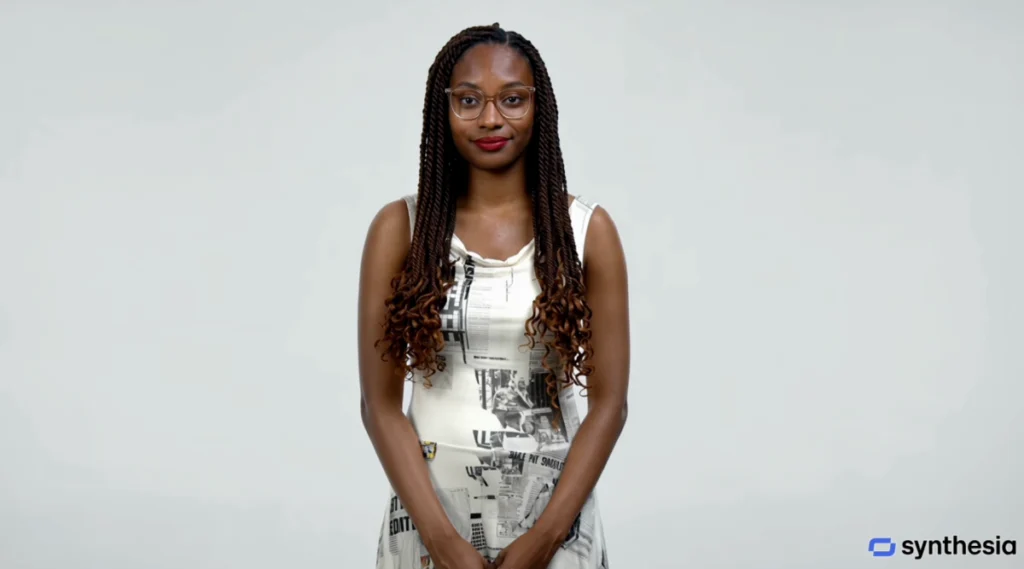
Il team di Synthesia, startup britannica specializzata nella generazione di video con avatar AI, ha realizzato per la prima volta un avatar digitale interattivo di un giornalista esterno. L’esperimento, condotto nell’ufficio di New York dell’azienda, ha permesso al giornalista di interagire con una sua replica virtuale addestrata a rispondere esclusivamente a domande su un suo articolo riguardante le frodi nelle startup finanziate da venture capital.
Synthesia e il mercato degli avatar digitali
Synthesia è considerata una delle startup più rilevanti nel settore degli avatar digitali, insieme a realtà come D‑ID, HeyGen e Colossyan. All’inizio dell’anno ha raggiunto una valutazione di 4 miliardi di dollari e, secondo i dati forniti dall’azienda, ha superato i 100 milioni di dollari di fatturato annuale ricorrente (ARR) l’anno precedente. La società offre tre tipologie di prodotto: una piattaforma di creazione e distribuzione video con avatar “classici”, un servizio chiamato “Roleplay Sessions” che consente agli utenti di esercitarsi in scenari come pitch di vendita con avatar interattivi, e una piattaforma API che permette di combinare i modelli video e voce di Synthesia con altri servizi tecnologici.
Realizzazione dell’avatar per il giornalista
Per creare l’avatar, il giornalista ha partecipato a una sessione fotografica all’interno di un mini‑studio presente negli uffici di Synthesia, dove sono state scattate numerose foto e registrati due minuti di voce. Sono stati prodotti quattro avatar: due “personali”, capaci di leggere qualsiasi copione fornito, e due “interattivi”, in grado di ascoltare e rispondere, entrambi disponibili con e senza occhiali. L’intero processo di realizzazione ha richiesto pochi giorni. L’avatar interattivo è stato addestrato su un singolo articolo del giornalista e, per design, risponde solo a domande relative a quel contenuto, reindirizzando ogni altra richiesta verso la storia di base.
Architettura tecnologica e opzioni di personalizzazione
Il funzionamento dell’avatar combina diversi modelli di intelligenza artificiale: un modello di riconoscimento vocale (voice‑to‑text) converte le parole dell’interlocutore in testo; un modello linguistico “agentic” interpreta il testo e decide l’azione da compiere; un modello di sintesi vocale (text‑to‑voice) genera l’audio della risposta; infine un modello video proprietario di Synthesia anima l’avatar mentre parla. Synthesia utilizza i propri modelli video e voce, ma consente ai clienti di scegliere alternative provenienti da laboratori come Cartesia, ElevenLabs, Google o OpenAI. Inoltre, le aziende possono ospitare gli avatar sui propri cloud o affidarsi al servizio di hosting di Synthesia.
Implicazioni per il giornalismo e le reazioni del pubblico
Il giornalista ha testato sia gli avatar personali, facendo parlare la replica di temi come l’arrivo dell’autunno a New York, sia gli avatar interattivi, ponendo domande sulla sua vita prima di TechCrunch o sul suo quartiere a New York, ma ricevendo risposte limitate al contenuto dell’articolo di riferimento. Amici non esperti di tecnologia hanno descritto l’esperienza come “interessante e inquietante”, mentre i genitori del giornalista hanno reagito con entusiasmo, definendola “straordinaria”. Il giornalista ha sollevato interrogativi sul futuro del giornalismo, chiedendosi se i lettori accetterebbero notizie presentate da un avatar e se la fiducia, elemento centrale della professione, possa mai essere delegata a un’intelligenza artificiale. Ha inoltre osservato che, sebbene la clonazione digitale possa risultare utile per gestire impegni lavorativi, la natura deterministica degli avatar attuali impedisce loro di evolvere spontaneamente, riducendo il rischio di “psicosi AI”.